Aide-mémoire regex : les expressions régulières expliquées avec des exemples
Les expressions régulières ont l'air obscures, mais elles reposent sur un petit nombre de briques. Cet aide-mémoire explique chacune avec un exemple clair, puis les assemble en motifs que vous utiliserez vraiment.
Réponse rapide
L'essentiel : . n'importe quel caractère, \d un chiffre, \w un caractère de mot, \s un espace, * zéro ou plus, + un ou plus, ? facultatif, {n,m} entre n et m, ^ début, $ fin, [abc] un caractère parmi un ensemble, (…) groupe de capture et a|b l'un ou l'autre. Testez chaque motif dans un testeur de regex avant de l'utiliser dans votre code.
Une expression régulière (regex) est un motif qui décrit du texte. On s'en sert pour rechercher, valider et remplacer : trouver tous les e-mails d'un document, vérifier qu'un code postal est valide, ou reformater des dates. Les regex fonctionnent dans presque tous les langages de programmation et dans des outils comme VS Code, Excel et Google Sheets.
Cet aide-mémoire utilise la syntaxe JavaScript, très proche de celle de Python, Java, PHP et de la plupart des autres langages.
Classes de caractères
| Motif | Correspond à | Exemple |
|---|---|---|
. | N'importe quel caractère sauf un saut de ligne | c.t trouve cat, cot, c9t |
\d | Un chiffre (0–9) | \d\d trouve 42 |
\w | Lettre, chiffre ou tiret bas | \w+ trouve user_1 |
\s | Espace blanc (espace, tabulation, saut de ligne) | a\sb trouve « a b » |
\D \W \S | L'inverse de \d, \w, \s | \D+ trouve abc |
[abc] | Un seul caractère parmi a, b ou c | gr[ai]s trouve gras, gris |
[^abc] | N'importe quel caractère sauf a, b, c | [^0-9] trouve tout sauf un chiffre |
[a-z] | Une plage | [A-Za-z] trouve n'importe quelle lettre ASCII |
Attention : \w et [a-z] ne couvrent pas les lettres accentuées comme é ou ç. Pour elles, utilisez \p{L} avec le flag u.
Quantificateurs
| Motif | Signification | Exemple |
|---|---|---|
* | 0 ou plus | ab*c trouve ac, abc, abbc |
+ | 1 ou plus | ab+c trouve abc, abbc (pas ac) |
? | 0 ou 1 (facultatif) | colou?r trouve color, colour |
{3} | Exactement 3 | \d{3} trouve 123 |
{2,4} | Entre 2 et 4 | \d{2,4} trouve 12, 123, 1234 |
{2,} | 2 ou plus | \w{2,} trouve les mots de 2 caractères ou plus |
*? +? | Paresseux : le moins possible | <.+?> trouve une balise HTML à la fois |
Les quantificateurs sont gourmands par défaut : ils prennent le plus de texte possible. Sur le texte <b>gras</b>, le motif <.+> prend toute la chaîne, alors que le motif paresseux <.+?> ne prend que <b>.
Ancres et limites
| Motif | Signification |
|---|---|
^ | Début du texte (ou de chaque ligne avec le flag m) |
$ | Fin du texte (ou de chaque ligne avec le flag m) |
\b | Limite de mot : \bchat\b trouve « chat » mais pas « chaton » |
Utilisez ^…$ pour valider une saisie entière. Sans ancres, \d+ trouve tranquillement le « 123 » au milieu de « abc123xyz ».
Groupes et alternatives
| Motif | Signification |
|---|---|
(abc) | Groupe de capture : mémorise la correspondance en $1, $2… |
(?:abc) | Groupe non capturant : regroupe sans mémoriser |
(?<year>\d{4}) | Groupe nommé, utilisé comme $<year> |
chat|chien | Soit chat, soit chien |
\1 | Référence arrière : le même texte que le groupe 1 |
Lookarounds (assertions avant et arrière)
Les lookarounds vérifient ce qui précède ou suit, sans l'inclure dans la correspondance :
| Motif | Signification | Exemple |
|---|---|---|
(?=…) | Suivi de | \d+(?=€) trouve 50 dans « 50€ » |
(?!…) | Non suivi de | \d+(?!€) |
(?<=…) | Précédé de | (?<=\$)\d+ trouve 50 dans « $50 » |
(?<!…) | Non précédé de | (?<!-)\d+ |
Flags
gglobal : trouve toutes les correspondances, pas seulement la première.iinsensible à la casse :/bonjour/itrouve « Bonjour ».mmultiligne :^et$s'appliquent à chaque ligne.sdotall :.trouve aussi les sauts de ligne.uunicode : active les classes\p{…}comme\p{L}, qui désigne n'importe quelle lettre de n'importe quelle langue.
Échapper les caractères spéciaux
Ces caractères ont un sens particulier : . * + ? ^ $ { } ( ) [ ] | \ /. Pour les trouver tels quels, placez une barre oblique inversée devant. \. trouve un vrai point, donc exemple\.fr ne trouve pas « exempleXfr ».
Motifs pratiques à copier
| Usage | Motif |
|---|---|
| Vérification simple d'e-mail | ^[^\s@]+@[^\s@]+\.[^\s@]+$ |
| URL (http/https) | https?:\/\/[^\s/$.?#].[^\s]* |
| Date (AAAA-MM-JJ) | ^\d{4}-(0[1-9]|1[0-2])-(0[1-9]|[12]\d|3[01])$ |
| Heure (24 h HH:MM) | ^([01]\d|2[0-3]):[0-5]\d$ |
| Couleur hexadécimale | ^#([0-9a-fA-F]{3}|[0-9a-fA-F]{6})$ |
| Code postal français | ^\d{5}$ |
| Nombre entier ou décimal | ^-?\d+(\.\d+)?$ |
| Espaces en trop | \s{2,} (à remplacer par un seul espace) |
| Espaces en fin de ligne | [ \t]+$ avec le flag m |
Astuce de validation : les regex sont parfaites pour repérer les fautes de frappe, mais elles ne peuvent pas confirmer qu'une adresse e-mail ou une URL existe vraiment. Pour les e-mails, un motif simple plus un e-mail de confirmation valent mieux qu'une regex « parfaite » de 200 caractères.
Comment tester une regex
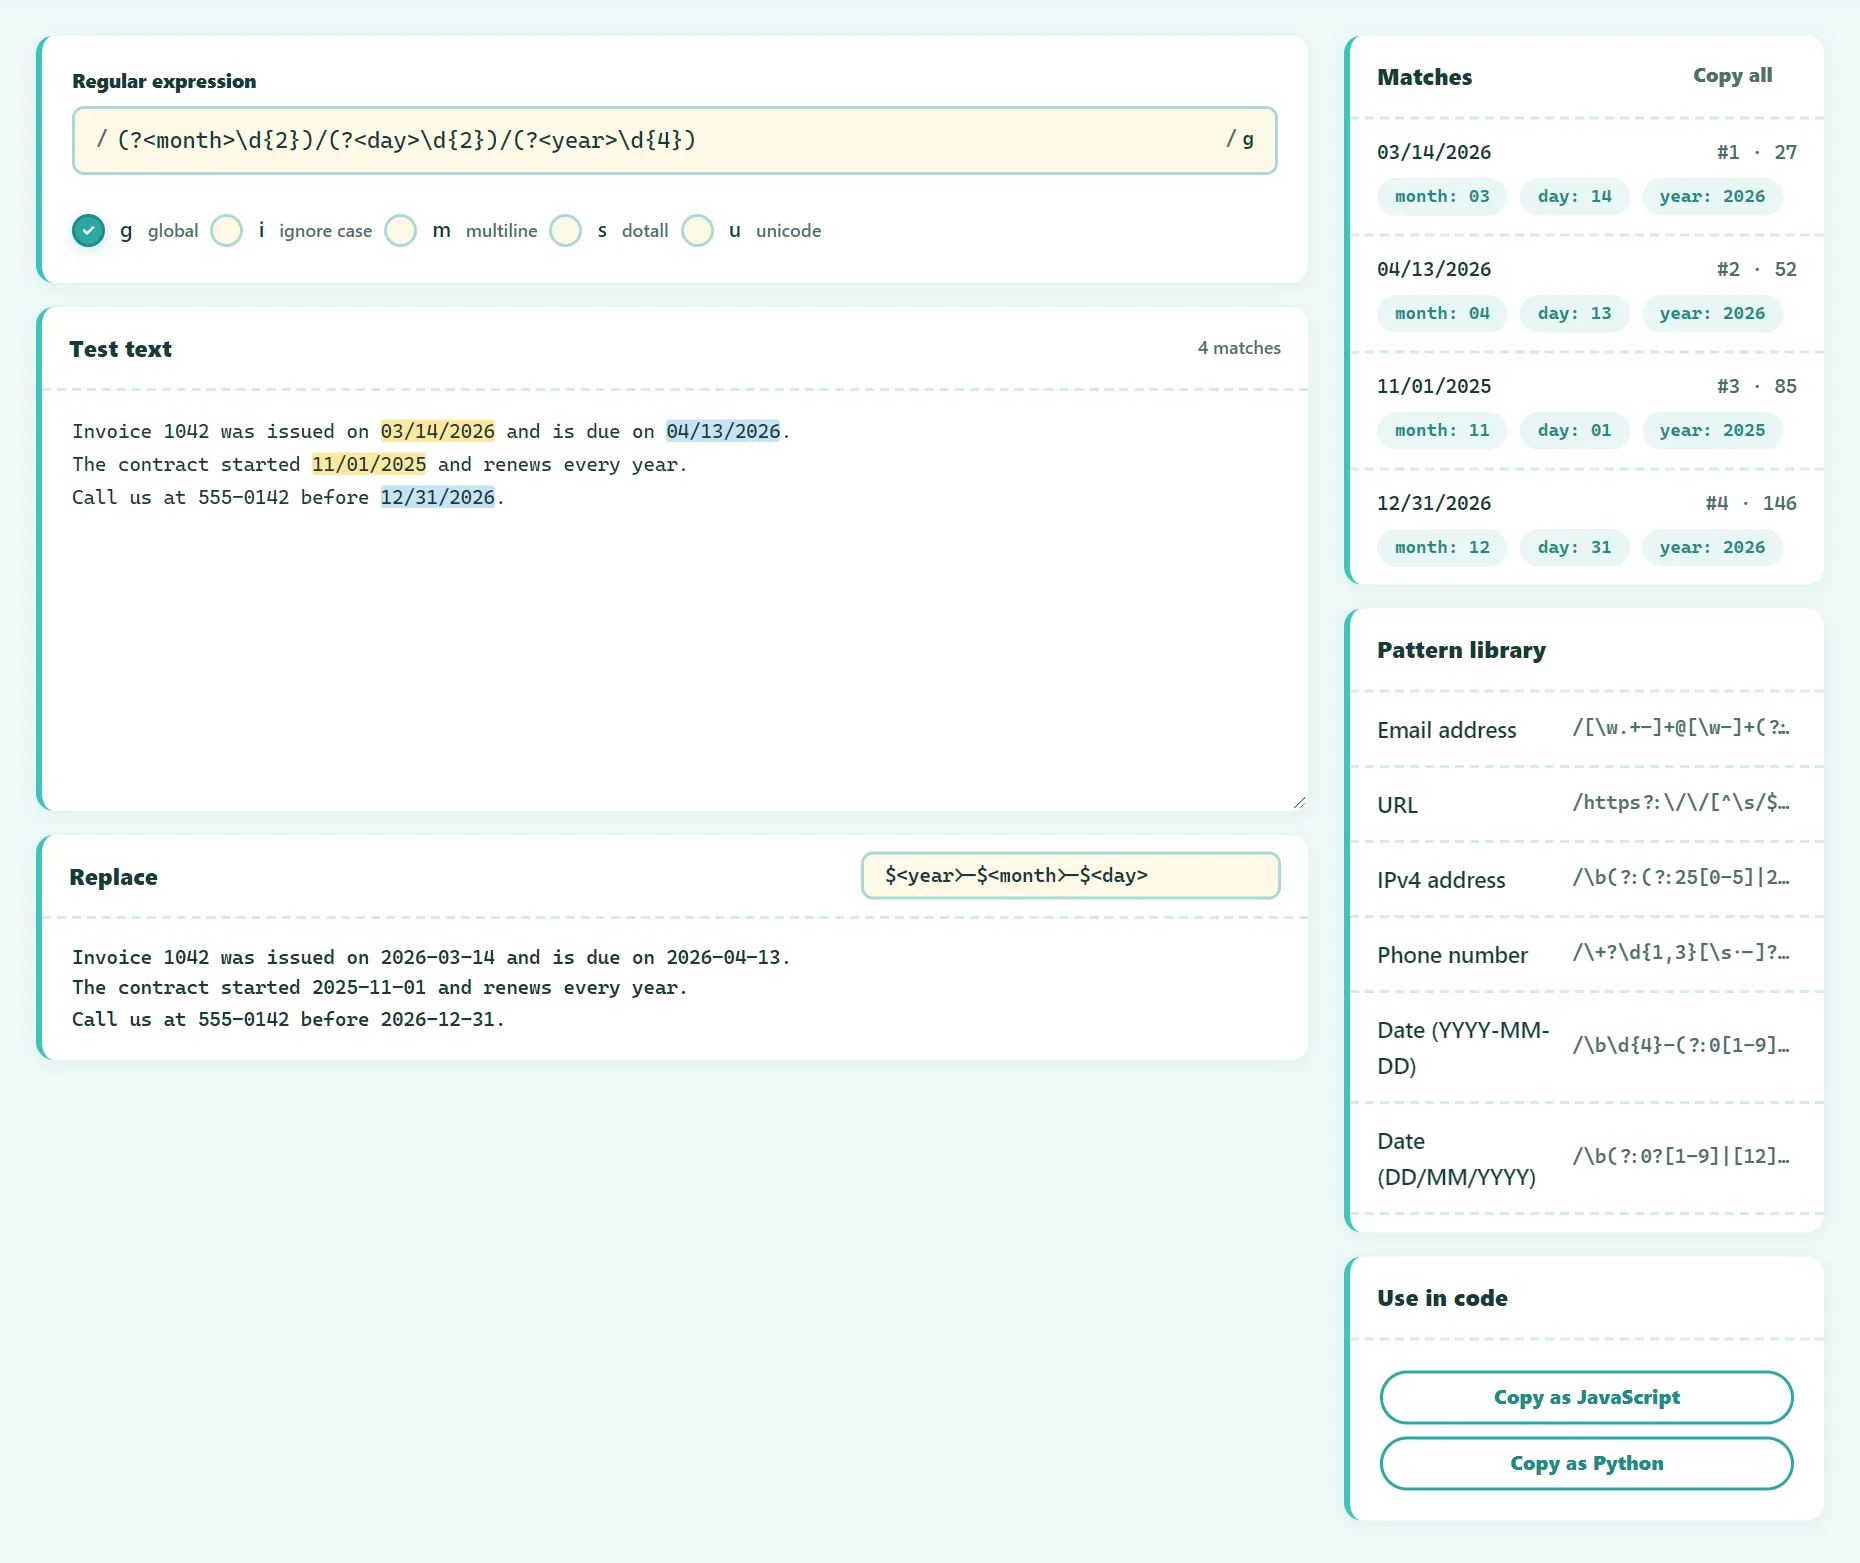
- Ouvrez le testeur de regex gratuit.
- Tapez votre motif et activez les flags (
g,i,m,s,u). - Collez un texte d'exemple, y compris des cas qui ne doivent pas correspondre.
- Vérifiez les correspondances surlignées et les groupes de capture listés pour chacune.
- Prévisualisez un remplacement avec
$1,$<name>ou$&. - Copiez le motif sous forme de code JavaScript ou Python.
Essai gratuit : Testeur de regex
Testez des expressions régulières en direct, avec les groupes capturés et une bibliothèque de motifs. Fonctionne dans votre navigateur, sans inscription.
Exemple : reformater des dates avec un remplacement
Transformez des dates françaises comme 31/12/2026 au format ISO 2026-12-31 :
Motif :        (\d{2})\/(\d{2})\/(\d{4})
Remplacement : $3-$2-$1
Avec des groupes nommés, c'est plus lisible :
Motif :        (?<d>\d{2})\/(?<m>\d{2})\/(?<y>\d{4})
Remplacement : $<y>-$<m>-$<d>
Erreurs fréquentes
- Oublier d'échapper le point.
.trouve n'importe quoi ; utilisez\.pour un point littéral. - Oublier les ancres dans les motifs de validation.
- Abuser de
.*. C'est gourmand et lent. Une classe précise comme[^"]*est plus sûre. - Le backtracking catastrophique. Des quantificateurs imbriqués comme
(a+)+$peuvent tourner indéfiniment sur certaines entrées et bloquer un programme. Notre testeur exécute les motifs avec une limite de temps et vous avertit. - Analyser du HTML avec des regex. Pratique pour une recherche rapide, mais utilisez un vrai analyseur HTML pour tout travail sérieux.
Questions fréquentes
Les regex sont-elles identiques dans tous les langages ?
La syntaxe de base est commune, mais les détails varient. Python utilise (?P<name>…) pour les groupes nommés, et certaines fonctions comme le lookbehind diffèrent selon les moteurs. Testez toujours dans la variante que vous utiliserez.
Que signifie \b ?
Une limite de mot : la position entre un caractère de mot et un caractère qui n'en est pas un. C'est ainsi qu'on ne trouve que des mots entiers.
Comment trouver un saut de ligne ?
Utilisez \n, ou \r?\n pour gérer aussi les fins de ligne Windows.
En résumé
Apprenez les briques de base (classes, quantificateurs, ancres et groupes) et la plupart des motifs deviennent lisibles. Gardez des motifs précis, ancrez-les pour valider et testez-les toujours sur de vrais exemples avant de les mettre en production.
Une information obsolète ou peu claire ? Écrivez à contact@ultratoolsai.com et nous la corrigerons.