Regex-Spickzettel: reguläre Ausdrücke mit Beispielen erklärt
Reguläre Ausdrücke wirken kryptisch, bestehen aber aus wenigen Bausteinen. Dieser Spickzettel erklärt jeden mit einem klaren Beispiel und setzt sie dann zu Mustern zusammen, die Sie wirklich brauchen.
Kurze Antwort
Das Wichtigste: . beliebiges Zeichen, \d Ziffer, \w Wortzeichen, \s Leerraum, * null oder mehr, + eins oder mehr, ? optional, {n,m} zwischen n und m, ^ Anfang, $ Ende, [abc] eines aus einer Menge, (…) Erfassungsgruppe und a|b entweder–oder. Testen Sie jedes Muster in einem Regex-Tester, bevor Sie es im Code verwenden.
Ein regulärer Ausdruck (Regex) ist ein Muster, das Text beschreibt. Damit suchen, prüfen und ersetzen Sie: alle E-Mail-Adressen in einem Dokument finden, eine Postleitzahl validieren oder Datumsangaben umformatieren. Regex funktioniert in fast jeder Programmiersprache und in Tools wie VS Code, Excel und Google Sheets.
Dieser Spickzettel nutzt die JavaScript-Syntax, die Python, Java, PHP und den meisten anderen Sprachen sehr ähnlich ist.
Zeichenklassen
| Muster | Trifft auf | Beispiel |
|---|---|---|
. | Jedes Zeichen außer einem Zeilenumbruch | c.t findet cat, cot, c9t |
\d | Eine Ziffer (0–9) | \d\d findet 42 |
\w | Buchstabe, Ziffer oder Unterstrich | \w+ findet user_1 |
\s | Leerraum (Leerzeichen, Tab, Zeilenumbruch) | a\sb findet „a b“ |
\D \W \S | Das Gegenteil von \d, \w, \s | \D+ findet abc |
[abc] | Eines der Zeichen a, b oder c | M[ae]ier findet Maier, Meier |
[^abc] | Jedes Zeichen außer a, b, c | [^0-9] findet jedes Nicht-Ziffer-Zeichen |
[a-z] | Ein Bereich | [A-Za-z] findet jeden ASCII-Buchstaben |
Achtung: \w und [a-z] erfassen keine Umlaute wie ä, ö, ü oder ß. Dafür nutzen Sie \p{L} mit dem Flag u.
Quantoren
| Muster | Bedeutung | Beispiel |
|---|---|---|
* | 0 oder mehr | ab*c findet ac, abc, abbc |
+ | 1 oder mehr | ab+c findet abc, abbc (nicht ac) |
? | 0 oder 1 (optional) | colou?r findet color, colour |
{3} | Genau 3 | \d{3} findet 123 |
{2,4} | Zwischen 2 und 4 | \d{2,4} findet 12, 123, 1234 |
{2,} | 2 oder mehr | \w{2,} findet Wörter ab 2 Zeichen |
*? +? | Genügsam: so wenig wie möglich | <.+?> findet jeweils ein HTML-Tag |
Quantoren sind standardmäßig gierig: Sie erfassen so viel wie möglich. Im Text <b>fett</b> erfasst das Muster <.+> den ganzen String, das genügsame <.+?> dagegen nur <b>.
Anker und Grenzen
| Muster | Bedeutung |
|---|---|
^ | Anfang des Textes (oder jeder Zeile mit dem Flag m) |
$ | Ende des Textes (oder jeder Zeile mit dem Flag m) |
\b | Wortgrenze: \bHaus\b findet „Haus“, aber nicht „Hausaufgabe“ |
Nutzen Sie ^…$, wenn Sie eine ganze Eingabe validieren. Ohne Anker findet \d+ auch die „123“ mitten in „abc123xyz“.
Gruppen und Alternativen
| Muster | Bedeutung |
|---|---|
(abc) | Erfassungsgruppe: merkt sich den Treffer als $1, $2 … |
(?:abc) | Nicht erfassende Gruppe: gruppiert, ohne zu merken |
(?<year>\d{4}) | Benannte Gruppe, verwendet als $<year> |
Katze|Hund | Entweder Katze oder Hund |
\1 | Rückverweis: derselbe Text wie Gruppe 1 |
Lookarounds
Lookarounds prüfen, was davor oder danach steht, ohne es in den Treffer aufzunehmen:
| Muster | Bedeutung | Beispiel |
|---|---|---|
(?=…) | Gefolgt von | \d+(?=€) findet 50 in „50€“ |
(?!…) | Nicht gefolgt von | \d+(?!€) |
(?<=…) | Vorangestellt | (?<=\$)\d+ findet 50 in „$50“ |
(?<!…) | Nicht vorangestellt | (?<!-)\d+ |
Flags
gglobal: findet alle Treffer, nicht nur den ersten.iGroß-/Kleinschreibung ignorieren:/hallo/ifindet „Hallo“.mmehrzeilig:^und$gelten für jede Zeile.sdotall:.findet auch Zeilenumbrüche.uUnicode: aktiviert Klassen wie\p{L}für jeden Buchstaben jeder Sprache.
Sonderzeichen maskieren
Diese Zeichen haben eine besondere Bedeutung: . * + ? ^ $ { } ( ) [ ] | \ /. Um sie wörtlich zu finden, setzen Sie einen Backslash davor. \. findet einen echten Punkt, also findet beispiel\.de nicht „beispielXde“.
Praktische Muster zum Kopieren
| Zweck | Muster |
|---|---|
| Einfache E-Mail-Prüfung | ^[^\s@]+@[^\s@]+\.[^\s@]+$ |
| URL (http/https) | https?:\/\/[^\s/$.?#].[^\s]* |
| Datum (JJJJ-MM-TT) | ^\d{4}-(0[1-9]|1[0-2])-(0[1-9]|[12]\d|3[01])$ |
| Uhrzeit (24 h HH:MM) | ^([01]\d|2[0-3]):[0-5]\d$ |
| Hex-Farbe | ^#([0-9a-fA-F]{3}|[0-9a-fA-F]{6})$ |
| Deutsche Postleitzahl | ^\d{5}$ |
| Ganzzahl oder Dezimalzahl | ^-?\d+(\.\d+)?$ |
| Doppelte Leerzeichen | \s{2,} (durch ein Leerzeichen ersetzen) |
| Leerraum am Zeilenende | [ \t]+$ mit dem Flag m |
Validierungstipp: Regex eignet sich hervorragend, um Tippfehler abzufangen, kann aber nicht bestätigen, dass eine E-Mail-Adresse oder URL wirklich existiert. Für E-Mails ist ein einfaches Muster plus Bestätigungs-E-Mail besser als eine „perfekte“ Regex mit 200 Zeichen.
So testen Sie eine Regex
- Öffnen Sie den kostenlosen Regex-Tester.
- Geben Sie Ihr Muster ein und schalten Sie Flags um (
g,i,m,s,u). - Fügen Sie Beispieltext ein, auch Fälle, die nicht passen sollen.
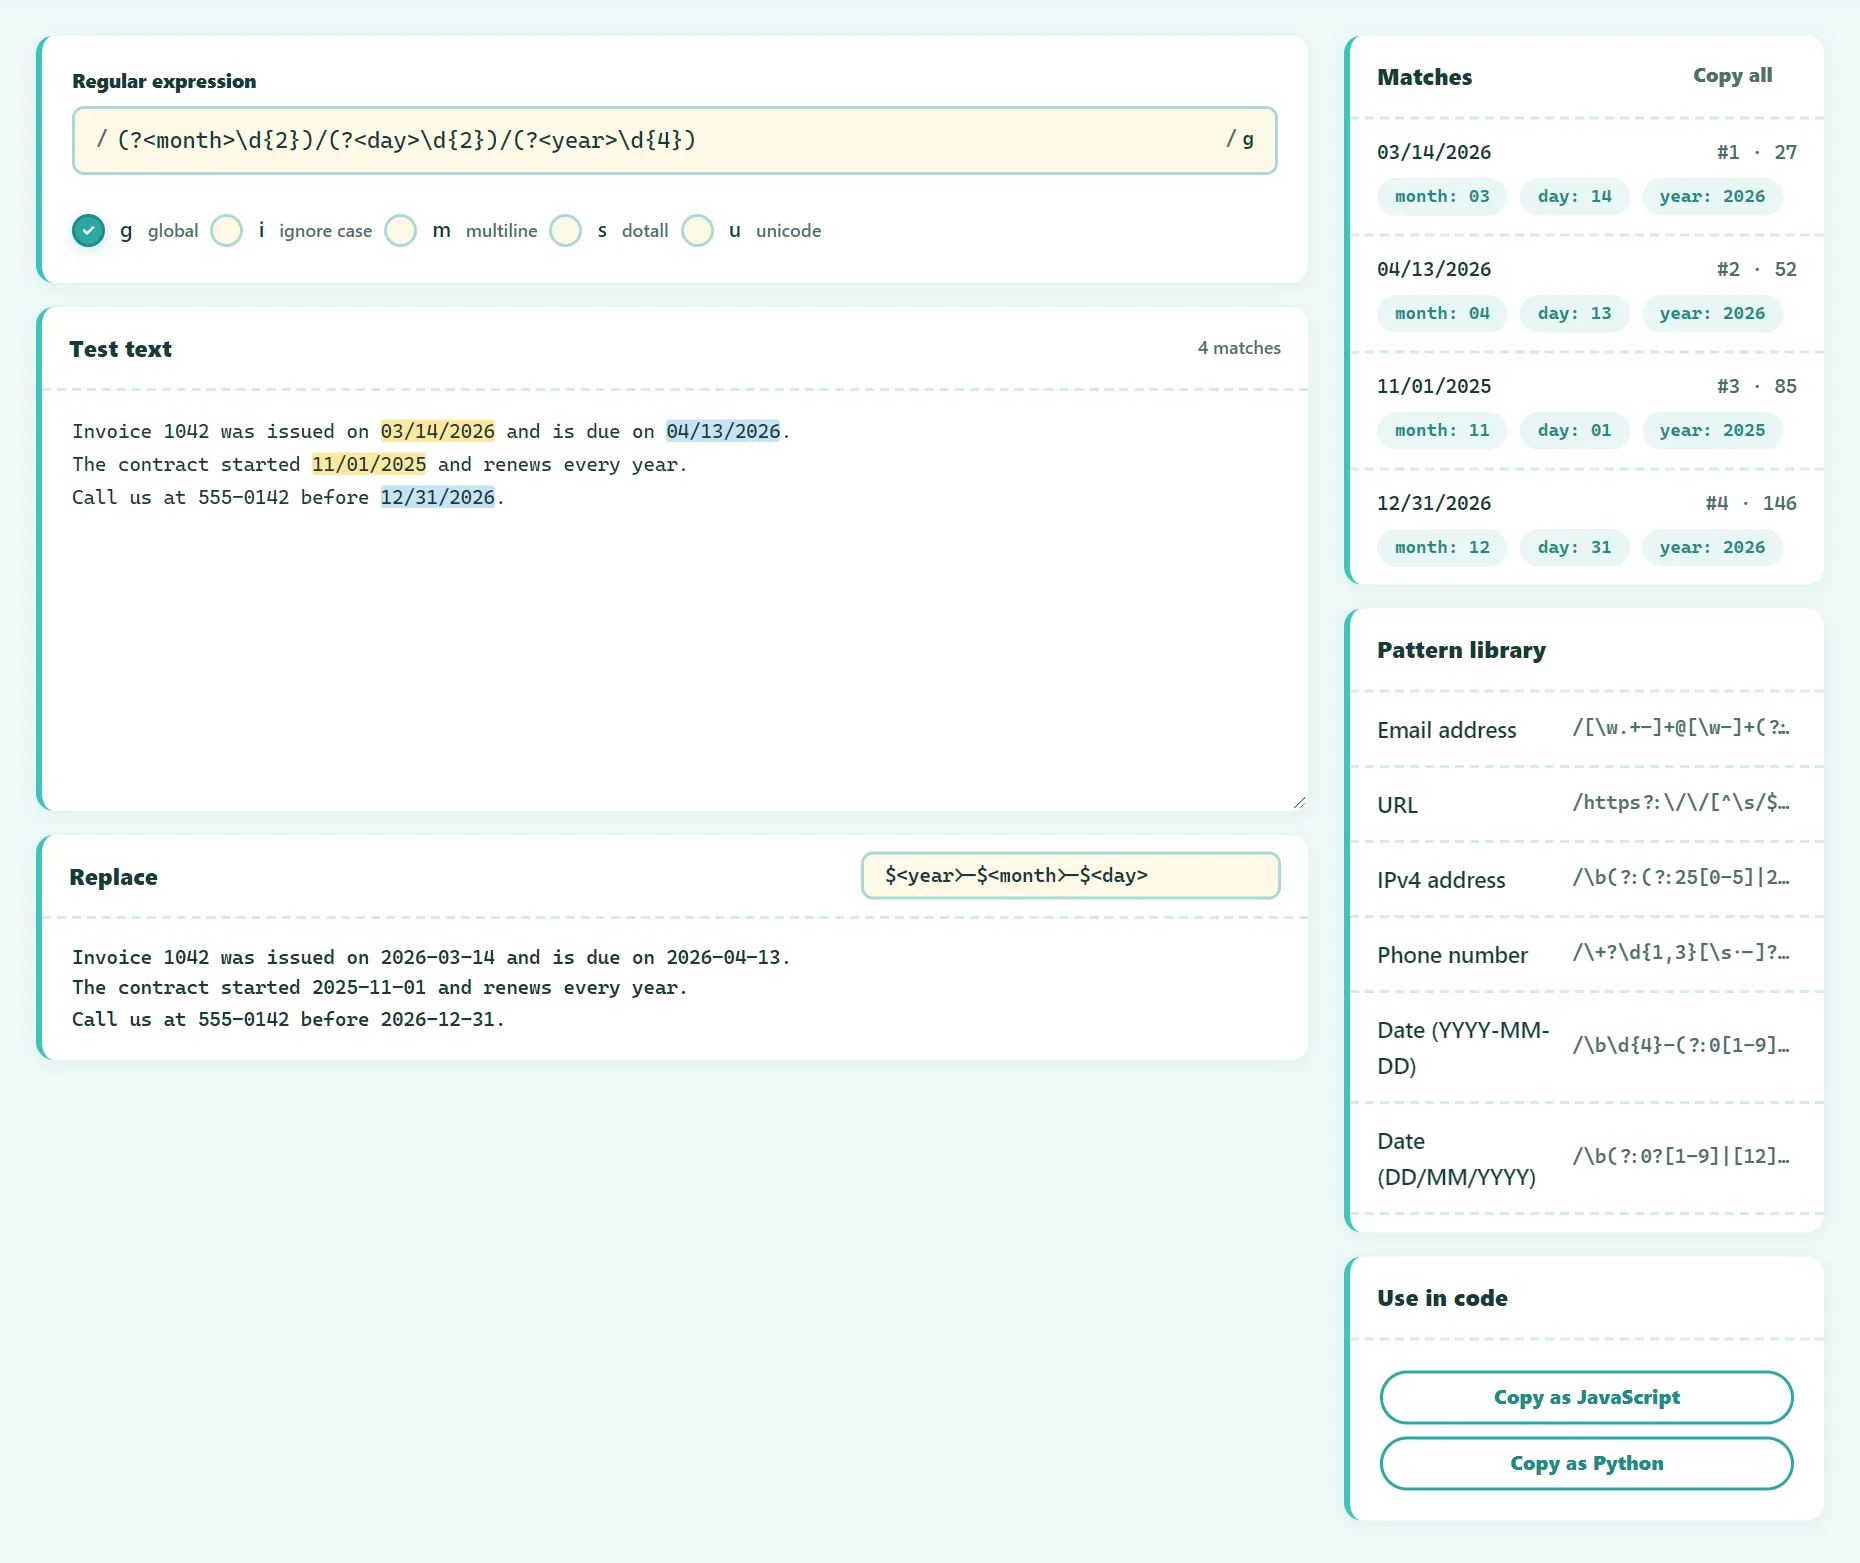
- Prüfen Sie die hervorgehobenen Treffer und die jeweils aufgelisteten Gruppen.
- Sehen Sie sich eine Ersetzung mit
$1,$<name>oder$&in der Vorschau an. - Kopieren Sie das Muster als JavaScript- oder Python-Code.
Kostenlos testen: Regex-Tester
Reguläre Ausdrücke live testen, mit Gruppen und einer Musterbibliothek. Läuft im Browser, ohne Anmeldung.
Beispiel: Datumsangaben per Ersetzung umformatieren
Wandeln Sie deutsche Daten wie 31.12.2026 in das ISO-Format 2026-12-31 um:
Muster:     (\d{2})\.(\d{2})\.(\d{4})
Ersetzung:  $3-$2-$1
Mit benannten Gruppen ist dasselbe leichter lesbar:
Muster:     (?<d>\d{2})\.(?<m>\d{2})\.(?<y>\d{4})
Ersetzung:  $<y>-$<m>-$<d>
Häufige Fehler
- Den Punkt nicht maskieren.
.findet alles; verwenden Sie\.für einen echten Punkt. - Fehlende Anker in Validierungsmustern.
- Zu viel
.*. Das ist gierig und langsam. Eine konkrete Klasse wie[^"]*ist sicherer. - Katastrophales Backtracking. Verschachtelte Quantoren wie
(a+)+$können bei bestimmten Eingaben ewig laufen und ein Programm einfrieren. Unser Tester führt Muster mit Zeitlimit aus und warnt Sie. - HTML mit Regex parsen. Für schnelle Suchen in Ordnung, für Ernsthaftes aber nutzen Sie einen echten HTML-Parser.
Häufige Fragen
Ist Regex in jeder Sprache gleich?
Die Grundsyntax ist gleich, die Details unterscheiden sich. Python nutzt (?P<name>…) für benannte Gruppen, und Funktionen wie Lookbehind variieren je nach Engine. Testen Sie immer in der Variante, die Sie verwenden.
Was bedeutet \b?
Eine Wortgrenze: die Position zwischen einem Wortzeichen und einem Nicht-Wortzeichen. So finden Sie nur ganze Wörter.
Wie finde ich einen Zeilenumbruch?
Verwenden Sie \n, oder \r?\n, um auch Windows-Zeilenenden zu erfassen.
Fazit
Lernen Sie die Bausteine (Klassen, Quantoren, Anker und Gruppen), und die meisten Muster werden lesbar. Halten Sie Muster konkret, verankern Sie sie bei der Validierung und testen Sie immer mit echten Beispielen, bevor Sie sie einsetzen.
Etwas veraltet oder unklar? Schreiben Sie an contact@ultratoolsai.com, und wir korrigieren es.