Quelle est cette langue ? Identifier une langue à partir d'un texte
Un message dans une langue inconnue, l'étiquette d'un produit, un commentaire sur votre site : avant de traduire, il faut savoir de quelle langue il s'agit. Voici comment identifier une langue instantanément, et quelques indices que vous pouvez repérer vous-même.
Réponse rapide
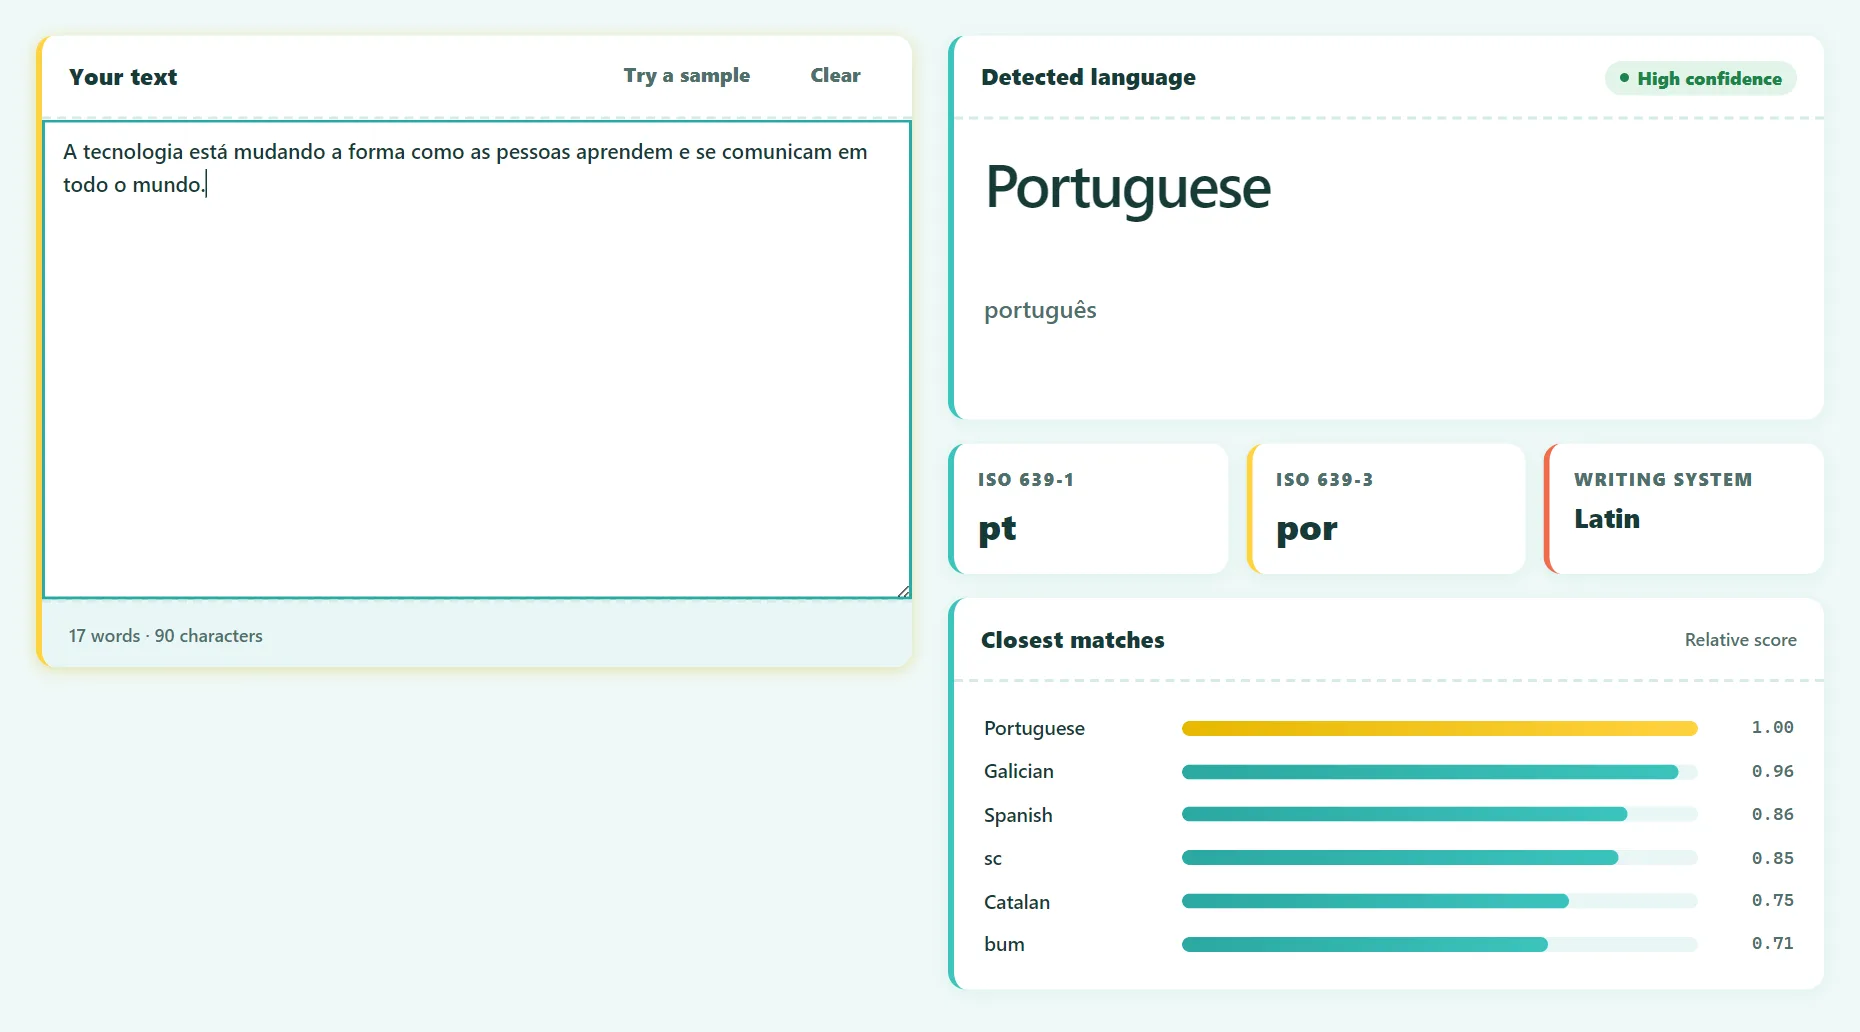
Collez le texte dans un détecteur de langue. Il compare les combinaisons de lettres du texte aux profils de plus de 180 langues et affiche la correspondance la plus probable, son code ISO et les alternatives proches. Utilisez au moins une phrase complète pour un résultat fiable.
Comment identifier une langue en quelques secondes
- Ouvrez le détecteur de langue gratuit.
- Collez ou tapez le texte. Une phrase de 20 caractères ou plus suffit généralement.
- Lisez la langue détectée, ses codes ISO 639 et son système d'écriture.
- Consultez la liste des alternatives quand deux langues apparentées obtiennent des scores proches.
Une fois la langue connue, collez le texte dans un traducteur en sélectionnant cette langue. La traduction est généralement plus précise qu'avec la détection automatique du traducteur.
Essai gratuit : Détecteur de langue
Identifiez la langue de n'importe quel texte parmi plus de 180 langues. Fonctionne dans votre navigateur, sans inscription.
Indice n° 1 : le système d'écriture
L'alphabet suffit souvent à réduire les possibilités à quelques langues :
| Écriture | Exemple | Langues courantes |
|---|---|---|
| Latine | Bonjour | Anglais, espagnol, français, allemand, turc, vietnamien, indonésien… |
| Cyrillique | Привет | Russe, ukrainien, bulgare, serbe, kazakh |
| Arabe | مرحبا | Arabe, persan, ourdou, pachto |
| Devanagari | नमस्ते | Hindi, marathi, népalais |
| Han (caractères chinois) | 你好 | Chinois ; aussi utilisé en japonais |
| Hiragana / Katakana | こんにちは | Japonais |
| Hangul | 안녕하세요 | Coréen |
| Grecque | Γεια σου | Grec |
| Hébraïque | שלום | Hébreu, yiddish |
| Thaïe | สวัสดี | Thaï |
Astuce utile : si un texte en caractères chinois contient aussi des caractères arrondis comme の ou は, c'est du japonais.
Indice n° 2 : les lettres spéciales et les accents
Dans l'alphabet latin, quelques caractères sont très révélateurs :
- ñ et ¿ ¡ : espagnol
- ã õ et ç : portugais (le ç existe aussi en français et en catalan)
- ß et des ä ö ü fréquents : allemand
- å avec ø ou æ : danois ou norvégien ; å ä ö : suédois
- ł ż ś ć : polonais
- ğ ş ı (i sans point) : turc
- ő ű : hongrois
- ơ ư et des accents superposés comme ệ : vietnamien
Indice n° 3 : les petits mots courants
Les petits mots grammaticaux apparaissent dans presque chaque phrase : « the » et « and » en anglais, « el », « la » et « que » en espagnol, « le », « la » et « et » en français, « der », « die » et « und » en allemand, « het » et « een » en néerlandais, « il » et « che » en italien.
Comment fonctionne la détection automatique
Chaque langue possède une empreinte statistique faite de courtes séquences de lettres. Les détecteurs découpent le texte en trigrammes (groupes de trois caractères qui se chevauchent) et les comptent. Un texte anglais regorge de « the », « ing » et « and », tandis que l'espagnol privilégie « que », « ció » et « los ».
Notre outil utilise la bibliothèque open source franc, qui vérifie d'abord l'écriture, puis compare les fréquences de trigrammes aux profils de plus de 180 langues. Le profil le plus proche l'emporte, et les correspondances suivantes s'affichent comme alternatives.
Pourquoi la détection se trompe parfois
- Texte très court. « No » existe dans des dizaines de langues. Utilisez au moins une phrase complète.
- Langues très proches. L'espagnol et le portugais, le tchèque et le slovaque, le serbe, le croate et le bosniaque, le malais et l'indonésien partagent une grande partie de leur vocabulaire.
- Texte mélangé. Un message moitié anglais, moitié hindi renvoie la langue dominante. Testez chaque partie séparément.
- Les noms, URL et nombres ajoutent du bruit sans donner d'indice sur la langue.
- Texte romanisé. L'hindi ou l'arabe écrits en lettres latines sont bien plus difficiles à identifier.
Les codes de langue ISO expliqués
Les développeurs et les traducteurs désignent les langues par des codes normalisés :
- ISO 639-1 : deux lettres, comme
en,es,fr,de,zh. - ISO 639-3 : trois lettres, couvrant des milliers de langues, comme
eng,spa,fra.
En HTML, l'attribut lang utilise ces codes (<html lang="fr">). Il aide les lecteurs d'écran à bien prononcer le texte et les moteurs de recherche à comprendre votre page.
Questions fréquentes
Combien de langues peuvent être détectées ?
Notre détecteur couvre plus de 180 langues et systèmes d'écriture.
Peut-il identifier une langue à partir d'une photo ?
Extrayez d'abord le texte avec un outil de conversion d'image en texte (OCR), puis collez le résultat dans le détecteur.
Peut-il identifier une langue parlée ?
Non, cet outil fonctionne sur du texte écrit. Pour un audio, transcrivez-le d'abord avec une application de reconnaissance vocale réglée sur la bonne langue.
Mon texte est-il envoyé quelque part ?
Non. La détection s'effectue entièrement dans votre navigateur.
En résumé
L'écriture et quelques lettres spéciales indiquent souvent la famille de langues au premier coup d'œil. Pour une réponse précise, collez une phrase complète dans un détecteur de langue, vérifiez les alternatives pour les langues proches, puis traduisez en sélectionnant la bonne langue.
Une information obsolète ou peu claire ? Écrivez à contact@ultratoolsai.com et nous la corrigerons.